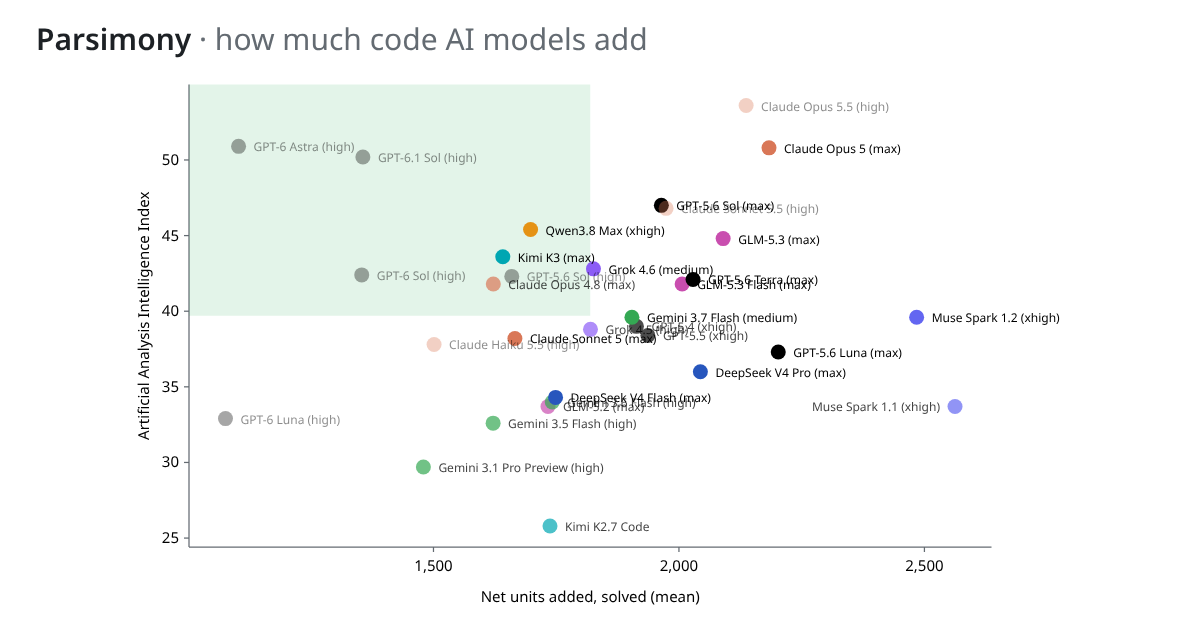
开源基准,衡量 AI 编程模型在解决任务时净增加的代码量,惩罚冗余代码。
适合评估 AI 编程模型代码简洁性的人,如开发者、模型评测者、技术选型团队。
开源 AI 工程平台,支持 LLM 与 ML 模型的追踪、评估、监控与部署。
开源 AI 工程平台,支持 LLM 应用与 Agent 的追踪、评估、监控和提示词优化。
开源 LLM 工程平台,集追踪、评估、提示词管理与实验于一体,支持自托管。
开源 LLM 评测与红队测试 CLI/库,可对比多模型、扫描漏洞并集成 CI/CD。
开源 LLM 评估框架,类似 Pytest,用 G-Eval 等指标本地评测 LLM 应用与 Agent
Google 官方 Gemini 模型在线试验与开发平台,从提示词快速走向生产。

 应用评测与监控应用评测与监控