韩国AI推理基础设施公司,提供高效能、低功耗的AI推理硬件与系统解决方案。
适合企业、AI服务商及国家项目用于高效部署生成式AI与智能体工作流。
本地大模型选型与硬件决策引擎,可查显存、比模型、算成本、生成装机方案。
检测本机 CPU、内存、GPU 与显存,推荐能流畅运行的本地开源大模型并估算速度。
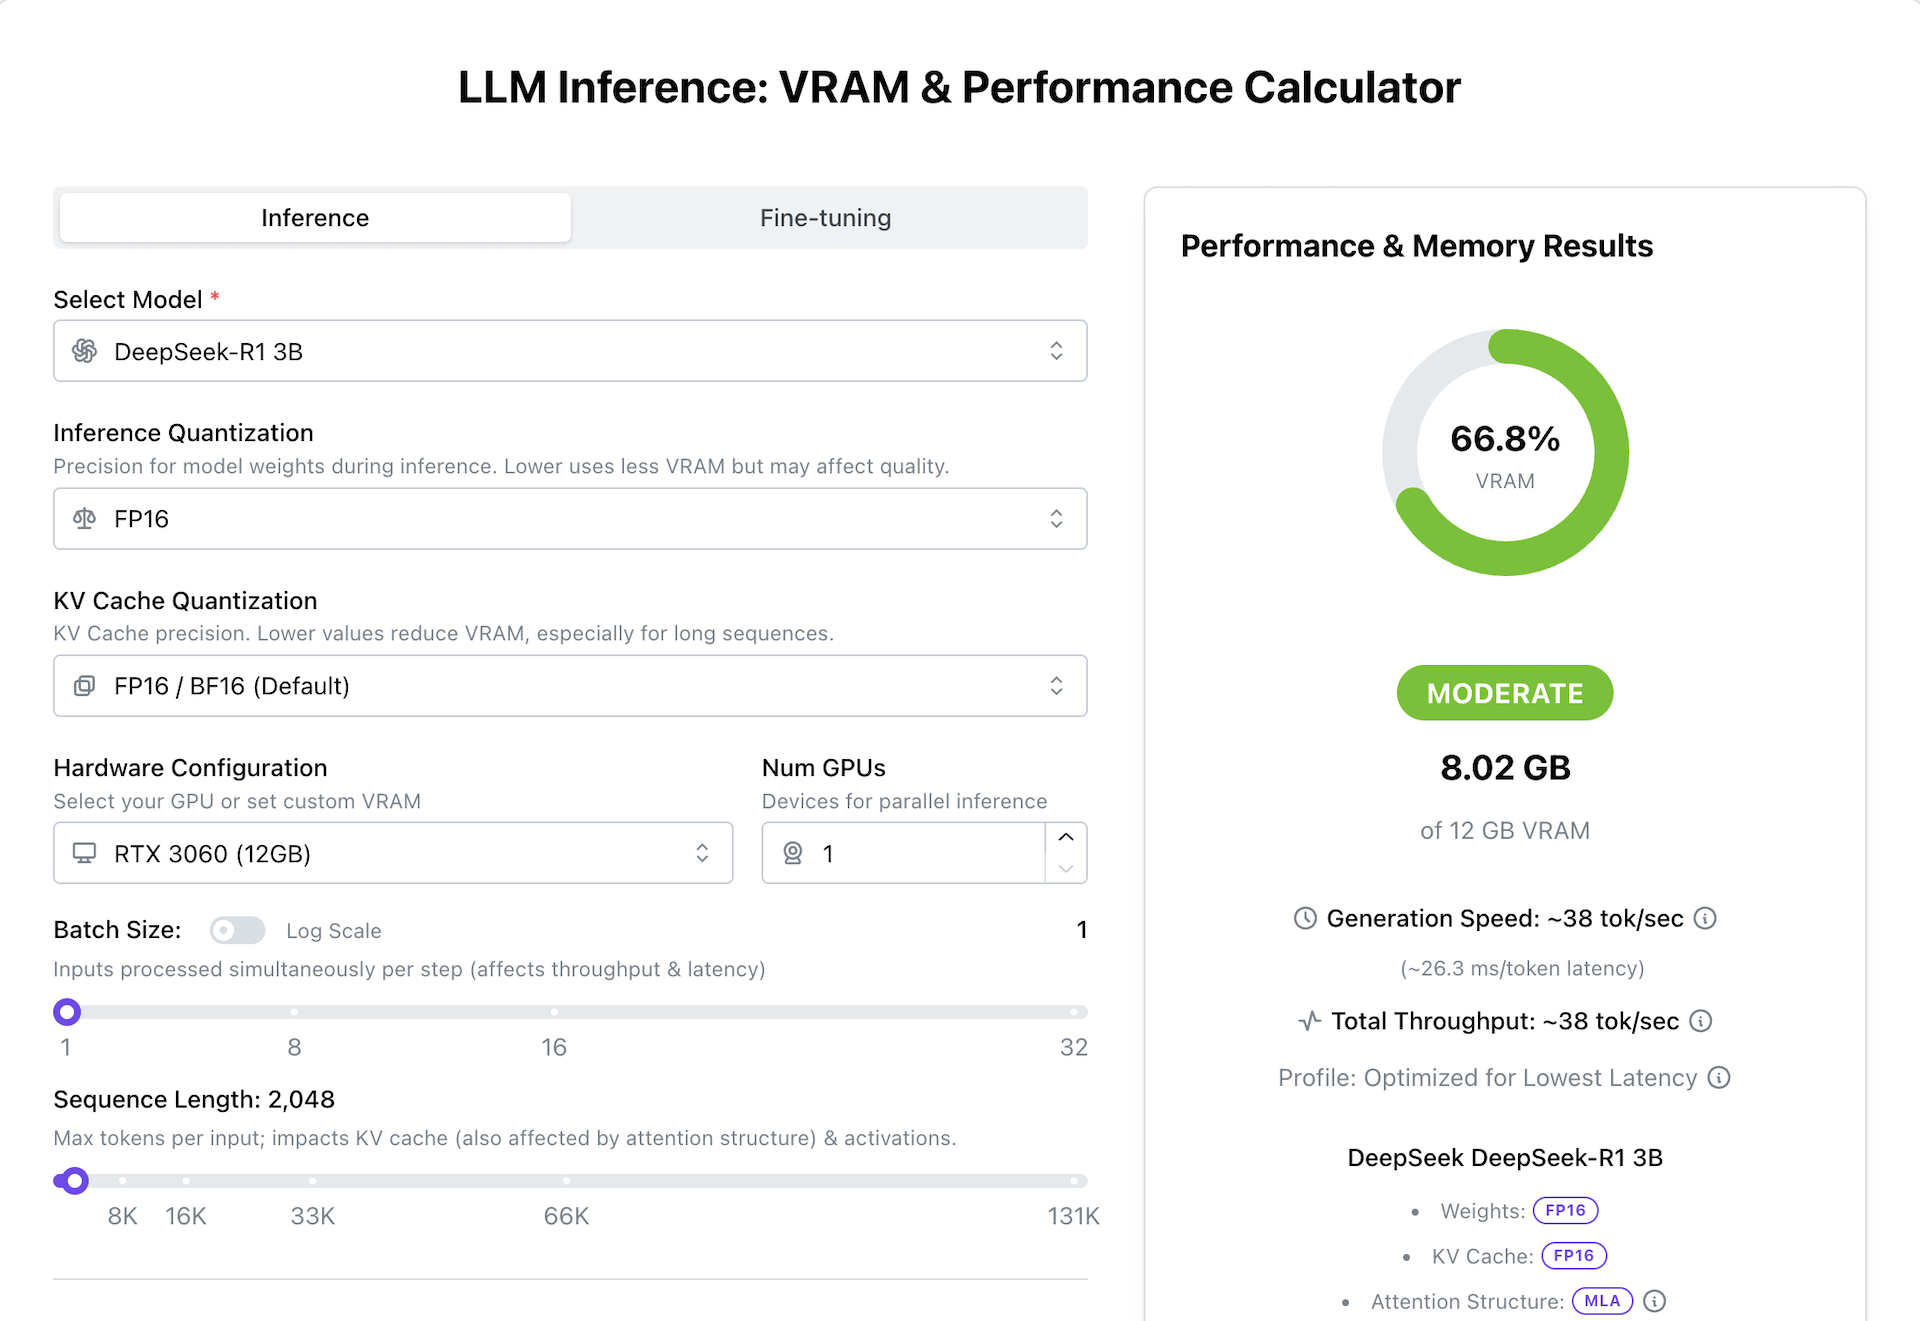
在线计算运行大模型所需显存、KV Cache 与生成速度,支持 Nvidia 与 Apple Silicon。
一键检测你的 GPU 或 Mac 能否本地运行 LLM、图像与视频模型,给出显存、量化与速度评估。
根据你的硬件配置推荐最适合本地运行的 AI 模型,提供速度与质量估算及一行 Ollama 安装命令。
查询本地运行各类 AI 模型所需硬件的数据库,收录 295+ 模型的显存需求与性能估算。

 本地硬件 / 显存计算
 本地硬件 / 显存计算
 本地硬件 / 显存计算
 本地硬件 / 显存计算本地硬件 / 显存计算本地硬件 / 显存计算本地硬件 / 显存计算本地硬件 / 显存计算