aiknow
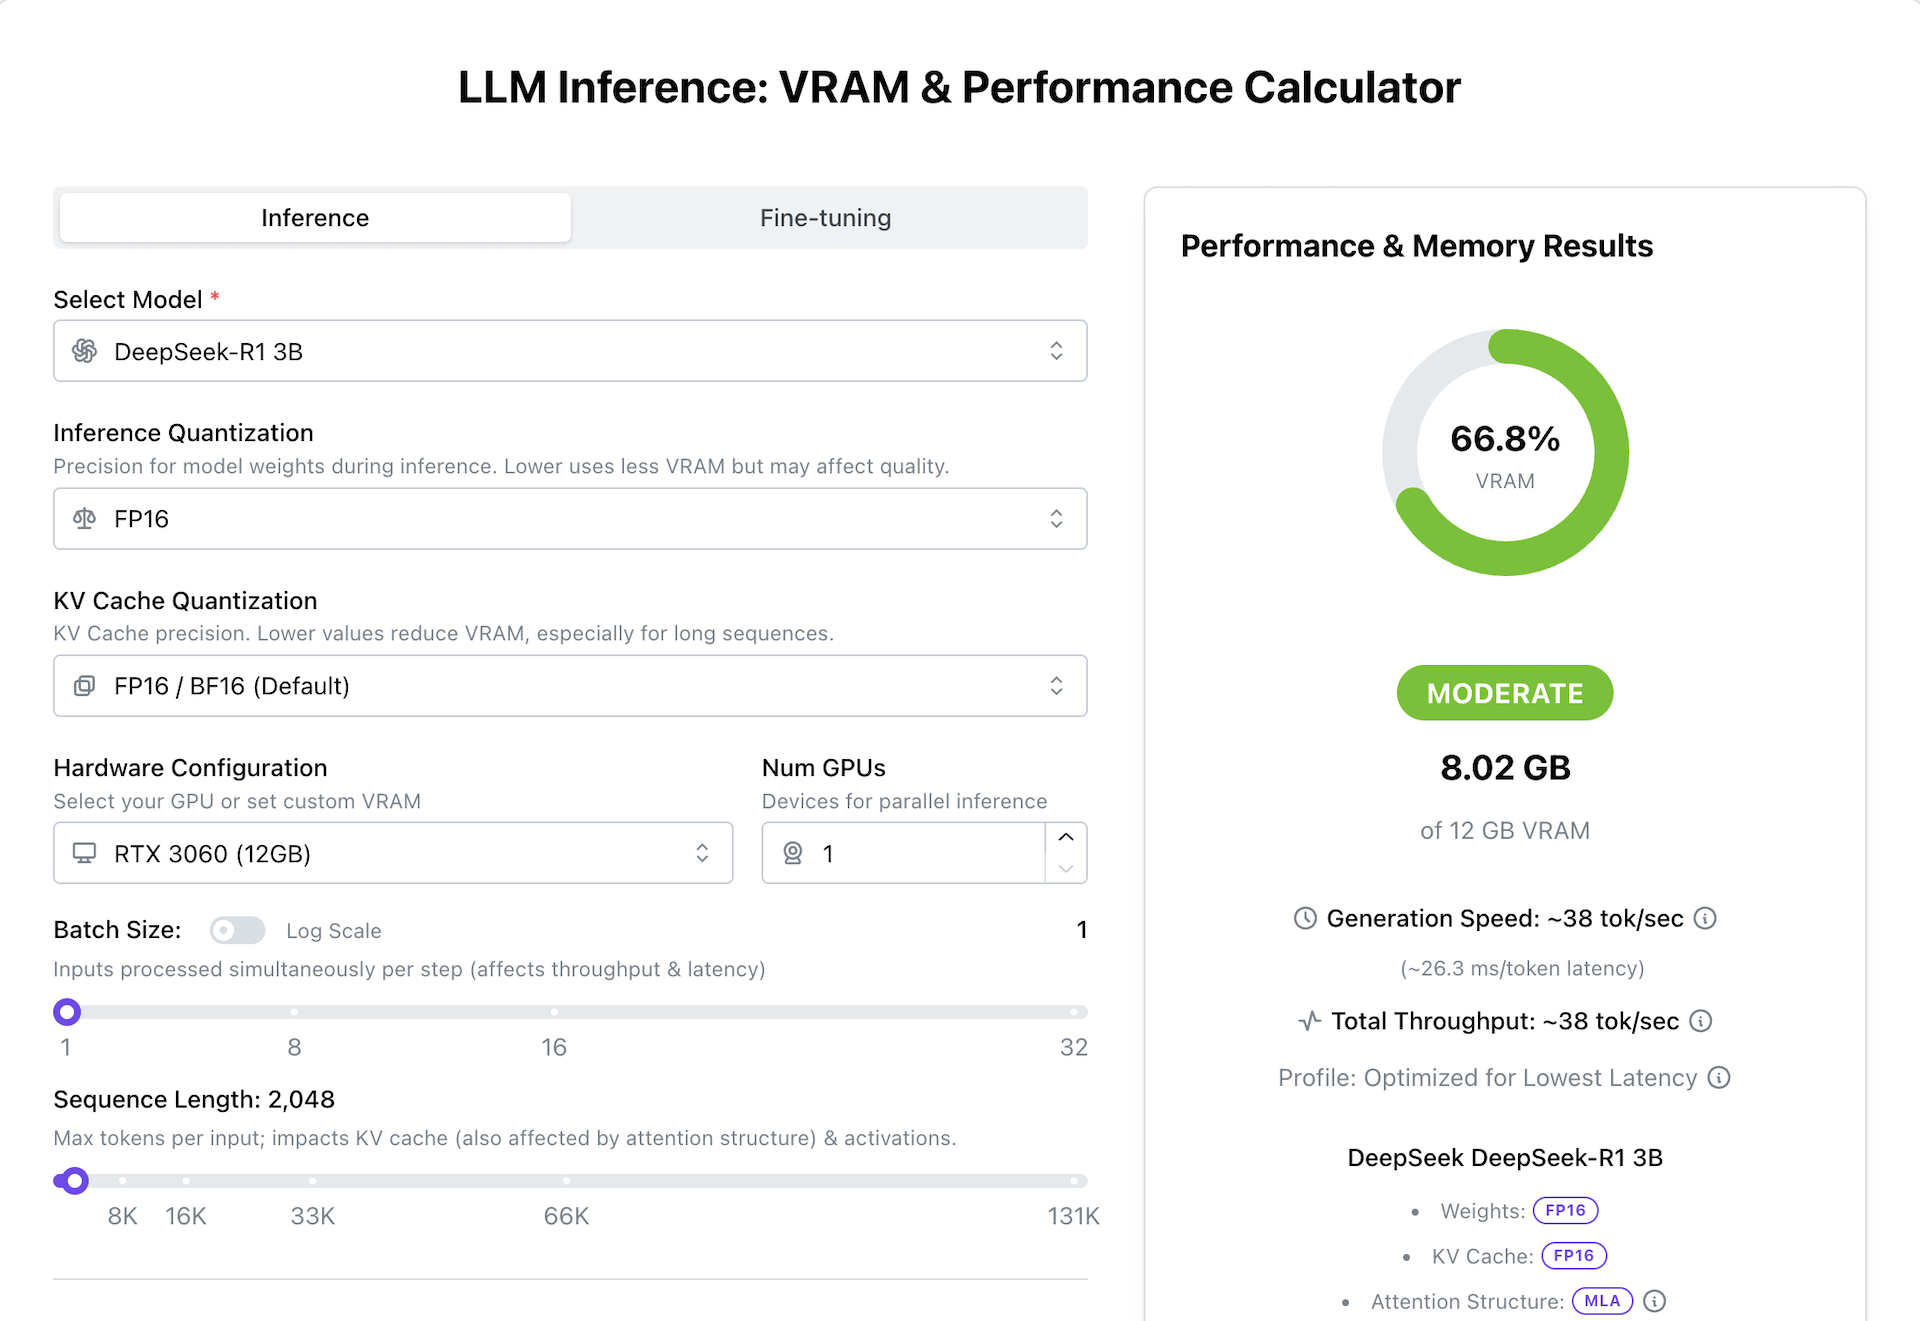
LLM VRAM Calculator

LLM VRAM Calculator

apxml.com

在线计算运行大模型所需显存、KV Cache 与生成速度,支持 Nvidia 与 Apple Silicon。

免费免登录本地模型网页
被推荐 1 次

适合做什么

适合想在本地跑大模型的用户,先算显存够不够、能跑多大模型、速度多快。

标签与属性

价格
特性
支持模型
平台

同类推荐

本地硬件 / 显存计算

本地大模型选型与硬件决策引擎,可查显存、比模型、算成本、生成装机方案。

免费免登录本地模型通义千问DeepSeek
llmconfigurator.com1 处推荐
本地硬件 / 显存计算

检测本机 CPU、内存、GPU 与显存,推荐能流畅运行的本地开源大模型并估算速度。

开源有 API可自部署本地模型命令行
github.com1 处推荐
本地硬件 / 显存计算

一键检测你的 GPU 或 Mac 能否本地运行 LLM、图像与视频模型,给出显存、量化与速度评估。

免费本地模型网页
willitrunai.com1 处推荐
本地硬件 / 显存计算

根据你的硬件配置推荐最适合本地运行的 AI 模型,提供速度与质量估算及一行 Ollama 安装命令。

开源可自部署免登录支持 MCP通义千问
modelfit.io1 处推荐
本地硬件 / 显存计算

查询本地运行各类 AI 模型所需硬件的数据库,收录 295+ 模型的显存需求与性能估算。

DeepSeek本地模型通义千问网页
runthisllm.com1 处推荐
本地硬件 / 显存计算

用 llama.cpp 实测多种 NVIDIA GPU 与 Apple Silicon 跑 LLaMA 模型的推理速度,含显存占用与 tokens/s 对比。

可自部署本地模型LinuxMacWindows
github.com1 处推荐