GPU-Benchmarks-on-LLM-Inference
github.com
用 llama.cpp 实测多种 NVIDIA GPU 与 Apple Silicon 跑 LLaMA 模型的推理速度,含显存占用与 tokens/s 对比。
可自部署本地模型LinuxMacWindows
GitHub ★ 1,939被推荐 1 次
适合做什么
适合想本地部署大模型、选购显卡或估算显存与推理速度的开发者参考。
标签与属性
同类推荐
 本地硬件 / 显存计算
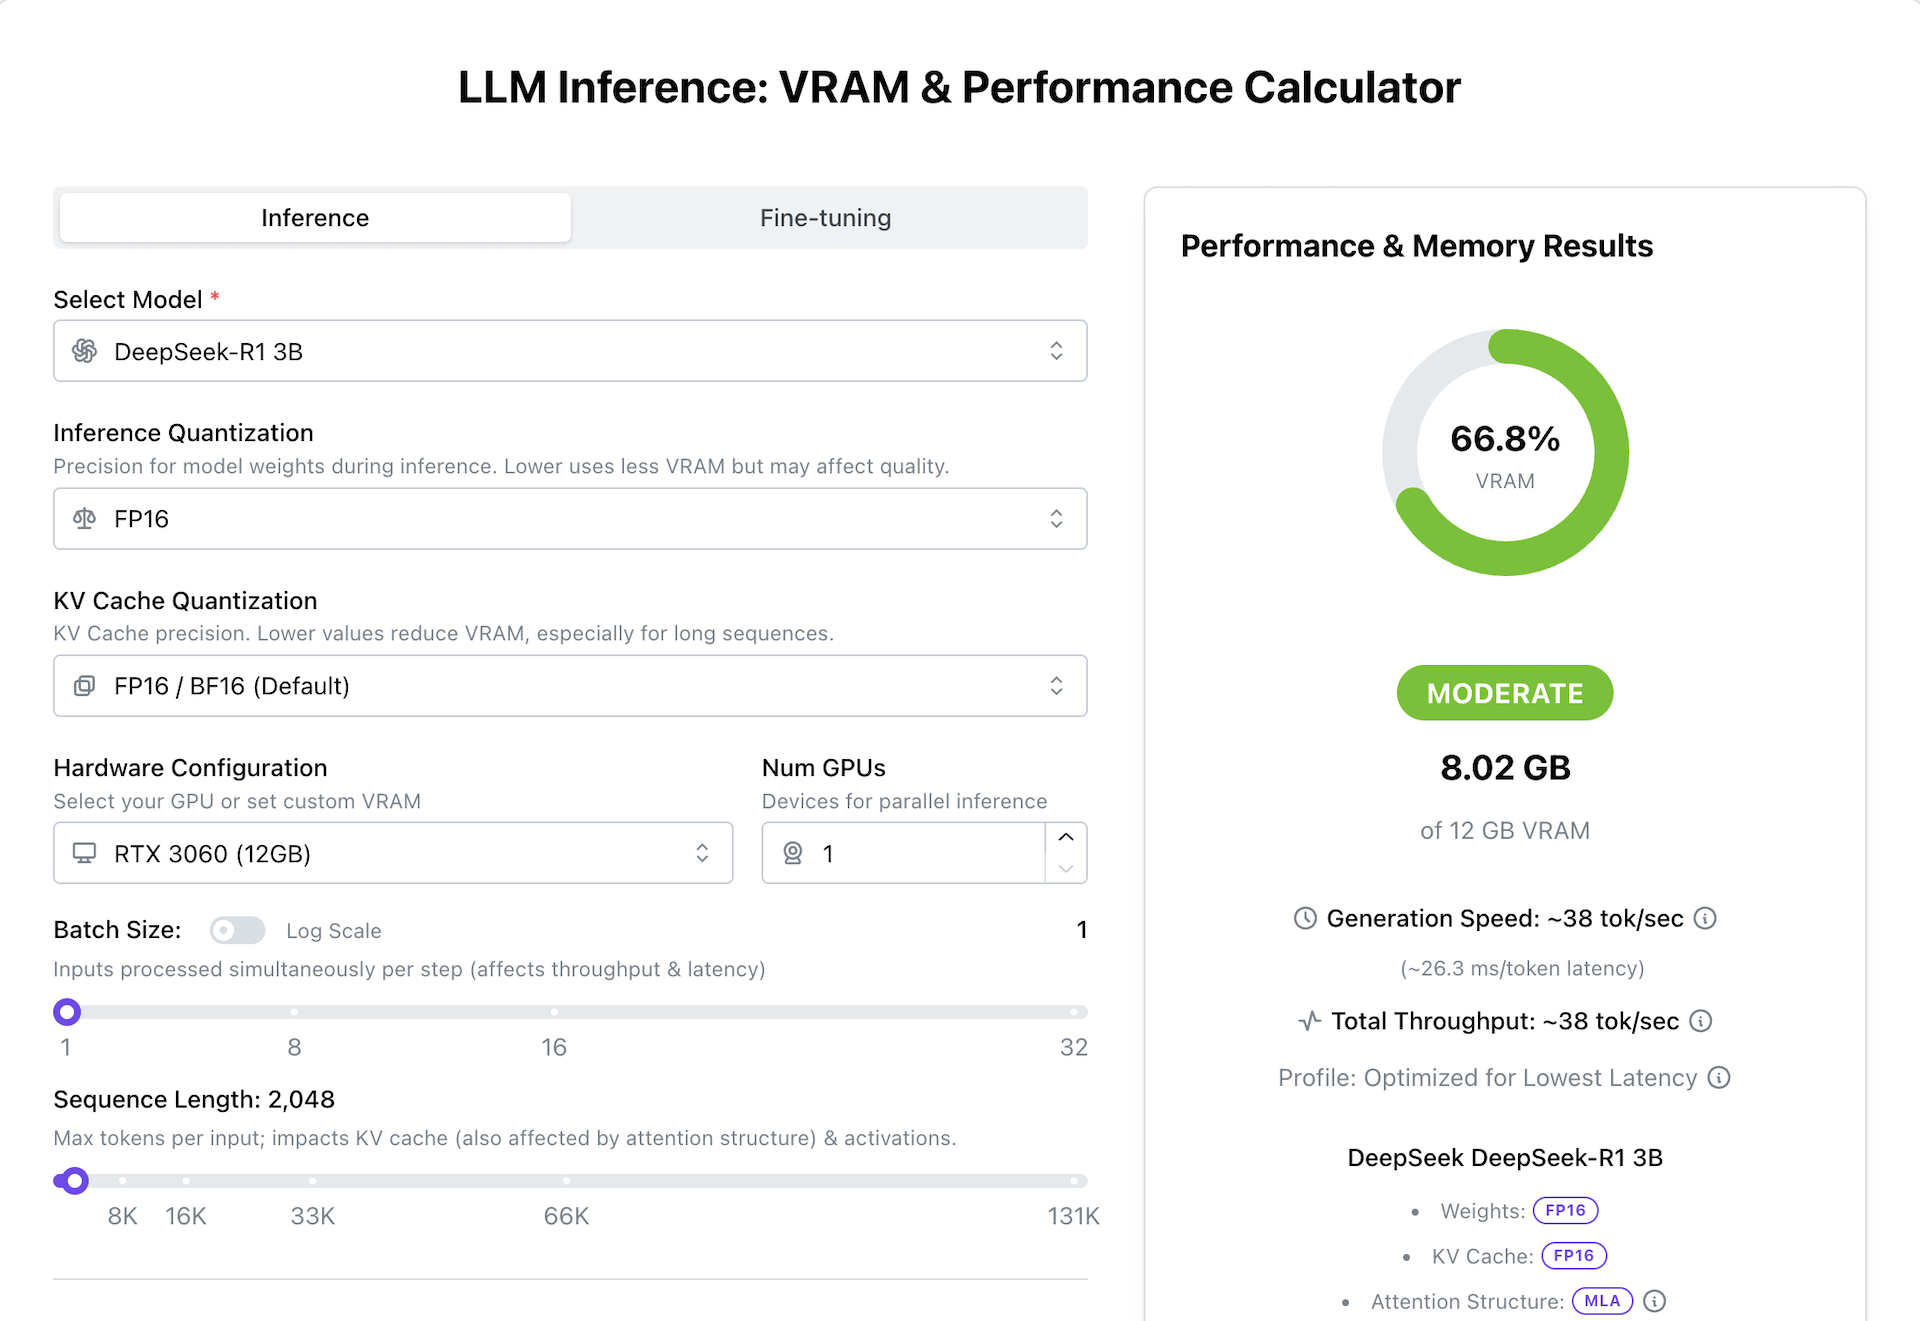 本地硬件 / 显存计算
 本地硬件 / 显存计算
 本地硬件 / 显存计算